پیش از آنکه کاربر خبر بدهد،مسئولش در جریان است
این سامانه سرورها، وبسایتها، APIها و پایگاههای داده را از یک جا زیر نظر میگیرد. وقتی سرویسی از کار میافتد، رخداد را برای پیمانکار و فرد مسئول همان سرویس باز میکند، اگر کسی جواب ندهد آن را به سطح بالاتر میبرد و در پایان هر ماه، SLA هر سرویس و کارنامهٔ هر پیمانکار را با عدد دقیق تحویل میدهد.
اعداد بر اساس آزمونهای پذیرش محصول
- قطعی از دو موقعیت پایش تأیید شد۰۴:۴۸:۱۰
- رخداد P1 باز شد و به پیمانکار سرویس رسید۰۴:۴۸:۲۸
- پیامک و تماس صوتی برای آمادهبهکار۰۴:۴۸:۴۵
- تأیید با پاسخ «۱» به پیامک۰۴:۵۱:۰۲
- سرویس برگشت؛ رخداد رفع شد۰۵:۰۹:۴۰
شش دردسر آشنا در سازمانهایی با چند پیمانکار
وقتی توسعه و پشتیبانی سرویسها میان چند پیمانکار تقسیم شده، مشکل معمولاً ابزار پایش نیست؛ این است که هشدار به دست چه کسی برسد و بعد از آن چه اتفاقی بیفتد.
کاربر زودتر از واحد فناوری از قطعی باخبر میشود
سرویسها از داخل سرور و از دید کاربر همزمان پایش میشوند و قطعی در چند ده ثانیه به دست مسئولش میرسد.
معلوم نیست مسئول هر سرویس کیست
هر سرویس شناسنامه دارد: پیمانکار، مسئول فنی، مخاطبان و برنامهٔ آمادهبهکار. پیامک به آدم درست میرسد.
سیل هشدارهای تکراری و کاذب
هشدارها در قالب یک رخداد ادغام میشوند، نوسان تشخیص داده میشود و قطعی شبکه بهجای دهها رخداد، یک رخداد باز میکند.
SLA آخر ماه روی اکسل چانهزنی میشود
SLA از تاریخچهٔ وضعیت، با دقت ثانیه و بر اساس ماه شمسی محاسبه میشود و با فرایند اعتراض و قفل ماه بسته میشود.
هر پیمانکار ابزار و گزارش خودش را دارد
همهٔ پیمانکاران در یک سامانه کار میکنند؛ هرکدام در فضای جداگانهٔ خودش و با شاخصهای یکسان و قابل مقایسه.
نگرانی از نصب Agent روی سرورهای حساس
Agent فقط ارتباط خروجی رمزنگاریشده دارد، هیچ پورتی باز نمیکند و فرمان دلخواه از راه دور نمیپذیرد.
از سرور تا گزارش ماهانه، در یک سامانه
پایش، رخداد، اطلاعرسانی و SLA چهار ابزار جدا نیستند؛ هرکدام دادهٔ بعدی را میسازد.
Agent سبک برای ویندوز و لینوکس
یک فایل اجرایی کوچک که منابع سرور، سرویسها و رویدادهای سیستم را جمع میکند و در قطعی شبکه داده را از دست نمیدهد.
- نصب با یک فرمان PowerShell یا Bash، یا بستهٔ MSI بیصدا
- فقط ارتباط خروجی gRPC با mTLS روی پورت ۴۴۳
- بافر محلی ۵۱۲ مگابایتی برای زمان قطعی شبکه
- تنها چهار فرمان مجاز از راه دور؛ بدون اجرای دستور دلخواه
کشف خودکار و بستههای فناوری
سرویسها و نرمافزارهای نصبشده روی هر سرور خودکار شناسایی میشوند و پایش مناسب هرکدام بدون نوشتن قاعده فعال میشود.
- IIS، Nginx، Apache، SQL Server، PostgreSQL، MySQL، Redis و Docker
- ۱۲ بستهٔ آماده با شاخصها و آستانههای از پیش تعریفشده
- آستانهها از Tier سرویس میآیند، نه از سلیقهٔ هر پیمانکار
- اسکریپت آمادهٔ دسترسی فقطخواندنی برای پایش پایگاه داده
کاتالوگ سرویس و وابستگیها
برای هر سرویس یک شناسنامه ساخته میشود تا روشن باشد چه چیزی، با چه اهمیتی و به عهدهٔ چه کسی است.
- Tier یک تا چهار، محیط، اجزا، مخاطبان و پیمانکار مسئول
- پیشنهاد وابستگیها از روی ارتباطات واقعی بین سرورها
- وقتی سرویس پایه قطع است، سرویسهای وابسته «افت کیفیت» میگیرند
- انتقال مالکیت سرویس بین پیمانکاران با تفکیک SLA بر اساس تاریخ
پایش از دید کاربر (Synthetic)
وبسایتها، APIها و سرویسهای بیرونی از چند موقعیت بررسی میشوند؛ همانطور که کاربر واقعی آنها را میبیند.
- شش نوع بررسی: HTTP(S)، TCP، DNS، TLS، Ping و سناریوی چندمرحلهای API
- بررسی کد پاسخ، کلمهٔ کلیدی، JSONPath، هدر و زمان پاسخ
- قطعی فقط با تأیید دستکم دو موقعیت سالم اعلام میشود
- پراب خصوصی برای سامانههای داخل شبکهٔ هر پیمانکار
رخداد، Escalation و آمادهبهکار
هر مشکل به یک رخداد با اولویت روشن تبدیل میشود و اگر کسی پاسخ ندهد، سطحبهسطح بالا میرود.
- اولویت P1 تا P4 از ترکیب Tier سرویس و نوع مشکل
- زنجیرهٔ Escalation با شبیهساز، پیش از فعالسازی
- برنامهٔ آمادهبهکار با جانشین موقت، ساعات اداری و تعطیلات رسمی
- پنجرهٔ نگهداری و سکوت؛ برای Tier یک و دو با تأیید NOC
اطلاعرسانی چندکاناله
پیام به کانالی میرود که در آن ساعت جواب میدهد، و با یک پاسخ ساده تأیید میشود.
- پیامک با دو سرویسدهنده و جایگزینی خودکار؛ تأیید با پاسخ «۱»
- تماس صوتی از طریق درگاه IVR، ایمیل و اعلان مرورگر
- سقف ارسال برای هر نفر و حالت طوفان با یک پیامک خلاصه
- پیگیری وضعیت تحویل هر پیام در تاریخچهٔ رخداد
لاگها
لاگ سرورها کنار متریکها و رخدادها نگه داشته میشود تا برای پیدا کردن علت، سراغ ابزار دیگری نروید.
- جمعآوری Event Log ویندوز و journald لینوکس
- جستجو بر اساس میزبان، منبع، شدت و متن در کمتر از یک ثانیه
- قاعدهٔ الگو: اگر عبارتی N بار در M دقیقه دیده شد، هشدار بده
- حذف رمز عبور و شمارهٔ کارت پیش از ارسال لاگ
یکپارچگی با ابزارهای موجود
لازم نیست ابزارهای فعلی کنار گذاشته شوند؛ هشدارهایشان به رخداد تبدیل میشود و در همین گردشکار قرار میگیرد.
- دریافت هشدار از Prometheus Alertmanager و Zabbix
- REST API با مستندات OpenAPI و توکنهای دارای دامنهٔ دسترسی
- Webhook امضاشده برای ۷ رویداد، با تلاش مجدد تا ۲۴ ساعت
- پایش Jobهای زمانبندیشده و پشتیبانگیری با Heartbeat
SLA، شاخص پیمانکاران و گزارش
عملکرد هر سرویس و هر پیمانکار با عدد سنجیده میشود؛ عددی که هر دو طرف قبولش دارند.
- SLA ماهانهٔ شمسی با دقت ثانیه، بودجهٔ خطا و نرخ مصرف آن
- MTTA، MTTR، رخدادهای تکراری و پاسخگویی خارج از ساعت اداری
- شش گزارش PDF فارسی و اکسل با ارسال خودکار هفتگی یا ماهانه
- کنسول NOC با حالت نمایش روی دیوار
نگاهی به صفحههای اصلی
تصاویر از نسخهٔ فعلی محصول و با دادهٔ نمونه گرفته شدهاند.
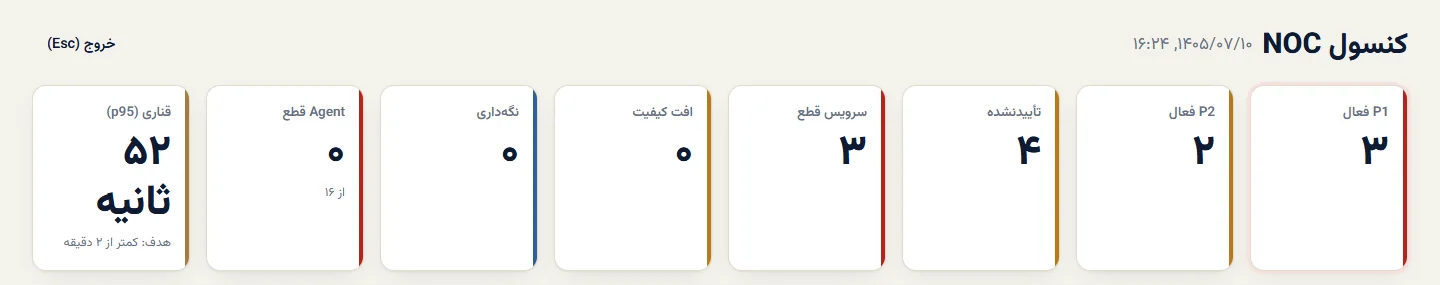
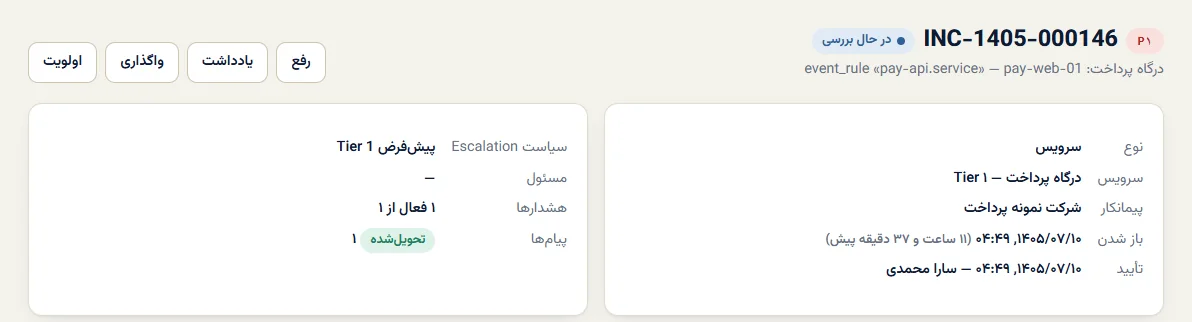
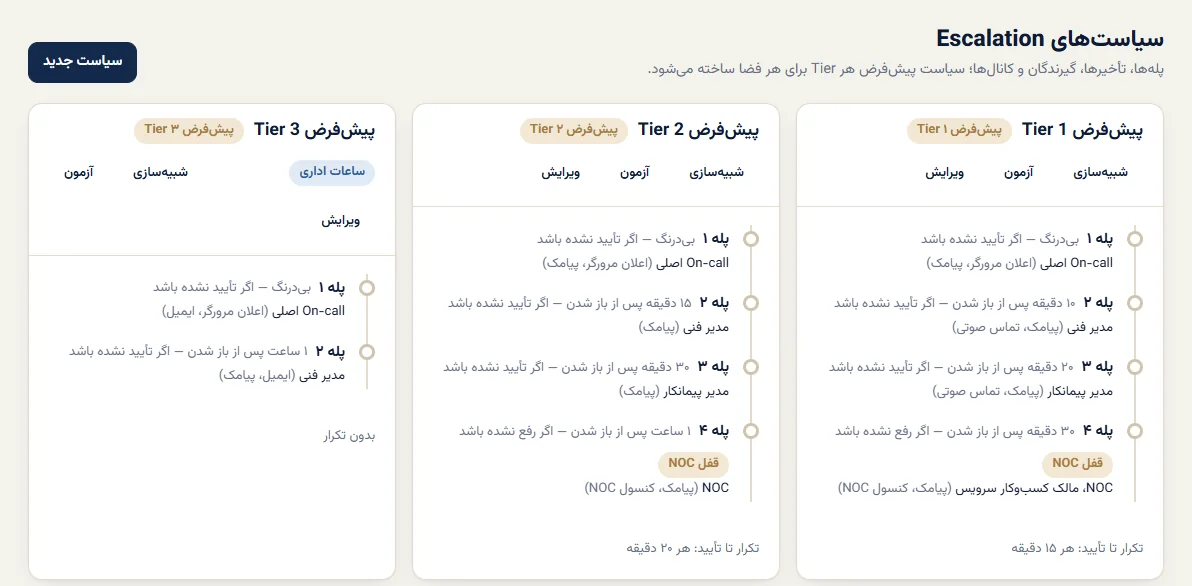
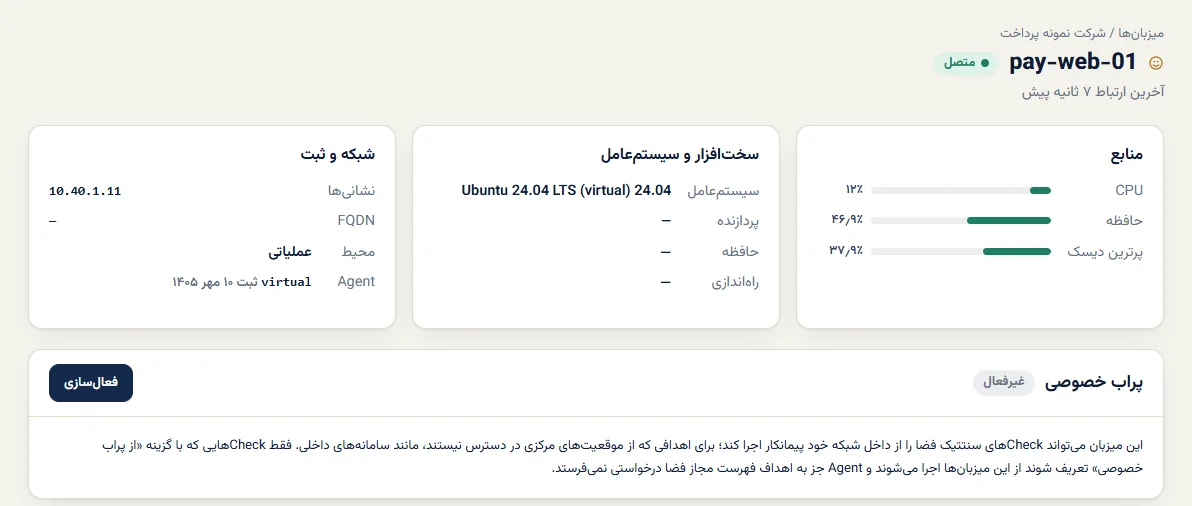
در لحظهٔ بحران چه اتفاقی میافتد؟
سه موقعیت رایج و مسیری که سامانه برای هرکدام طی میکند
نیمهشب، درگاه پرداخت از دسترس خارج میشود
- ۱دو موقعیت پایش، قطعی را مستقل از هم تأیید میکنند
- ۲حدود ۱۸ ثانیه بعد، رخداد P1 برای پیمانکار همان سرویس باز میشود
- ۳آمادهبهکار پیمانکار پیامک و تماس صوتی دریافت میکند
- ۴با پاسخ «۱» رخداد را تأیید میکند و Escalation متوقف میشود
- ۵اگر تا ۱۰ دقیقه تأیید نمیکرد، مدیر فنی خبردار میشد
یک شبکهٔ کامل قطع میشود
- ۱دهها Agent همزمان ساکت میشوند
- ۲سامانه تشخیص میدهد مشکل از شبکه است، نه از تکتک سرورها
- ۳بهجای دهها رخداد، یک رخداد «قطع شبکه» باز میشود
- ۴سرویسهای وابسته «افت کیفیت» نشان داده میشوند
- ۵در آزمون، طوفان ۵۰۰ هشداری به ۱۲ رخداد رسید و هیچ پیامک تکراری ارسال نشد
پایان ماه و بستن SLA
- ۱پیشنویس SLA هر سرویس خودکار ساخته میشود
- ۲پیمانکار تا پنجمین روز کاری فرصت ثبت اعتراض دارد
- ۳NOC دربارهٔ اعتراضها تصمیم میگیرد
- ۴ماه قفل میشود و PDF گزارش با هش SHA-256 ثبت میشود
- ۵هر اصلاح بعدی فقط بهصورت نسخهٔ جدید امکانپذیر است
هر کس همان چیزی را میبیند که به کارش میآید
۹ نقش آماده و ۲۰ مجوز مشخص؛ از اپراتور NOC تا پاسخگوی آمادهبهکار پیمانکار
سازمان و مرکز عملیات
نمای کامل همهٔ سرویسها و پیمانکاران، تعریف سیاستها و تصمیم دربارهٔ SLA.
پیمانکاران
هر پیمانکار فضای جداگانهٔ خودش را دارد و فقط میزبانها، سرویسها و رخدادهای خودش را میبیند.
اعدادی که اندازه گرفتهایم، نه وعده دادهایم
این اعداد از آزمونهای پذیرش محصول به دست آمدهاند و در هر استقرار به زیرساخت سازمان بستگی دارند.
ساختهشده برای زیرساختهای حساس
ابزاری که به همهٔ سرورهای سازمان دسترسی دارد، خودش باید امنترین بخش زیرساخت باشد. سامانه کاملاً روی سرورهای سازمان نصب میشود و خودارزیابی امنیتی آن بر پایهٔ استاندارد OWASP ASVS سطح ۲ انجام شده است.
- نصب کامل روی زیرساخت سازمان؛ دادههای پایش از شبکهٔ سازمان خارج نمیشود
- ورود یکپارچه با Keycloak و اتصال به LDAP و Active Directory
- ورود دومرحلهای (TOTP) اجباری و قفل حساب پس از ۵ تلاش ناموفق
- محدود کردن ورود هر پیمانکار به بازهٔ IP مشخص
- گزارش ممیزی زنجیرهای با هش SHA-256 و ارسال به SIEM از طریق Syslog یا CEF
- بازبینی دورهای دسترسیها هر ۹۰ روز
- گواهی ۳۰ روزهٔ Agent با تمدید خودکار و ابطال در حدود ۲ ثانیه
- انتشار امضاشدهٔ نسخههای Agent بهصورت حلقهای، با بازگشت خودکار
- جداسازی دادهٔ پیمانکاران در سطح پایگاه داده (Row-Level Security)
- پشتیبان رمزنگاریشده و سناریوی آزمودهشدهٔ بازیابی از فاجعه
فناوریهای بهکاررفته
همهٔ اجزا متنباز و قابل نصب روی سرورهای سازمان هستند؛ بدون وابستگی به سرویس ابری خارجی.
هستهٔ پردازش
- Go
- gRPC و Protocol Buffers
- Apache Kafka
- اجرای دوگانهٔ موتور رخداد و گزارش برای دسترسپذیری بالا
ذخیرهسازی
- PostgreSQL با Row-Level Security
- VictoriaMetrics برای متریکها
- ClickHouse برای لاگها
- Valkey
امنیت
- Keycloak (OIDC)
- OpenBao برای اسرار و گواهیها
- mTLS بین Agent و سرور
- امضای ECDSA نسخهها
رابط کاربری
- React و TypeScript
- نمودارهای ECharts
- فارسی، راستچین و تقویم شمسی
- حالت تیره و سازگار با موبایل
پرسشهایی که معمولاً در جلسهٔ اول مطرح میشود
خیر. تمام اجزای سامانه روی سرورهای خود سازمان نصب میشود و متریکها، لاگها و رخدادها در همانجا میمانند. ارتباط بیرونی فقط برای ارسال پیامک و تماس صوتی از طریق درگاهی که سازمان انتخاب میکند لازم است، و در صورت تمایل برای اعلان مرورگر.
سامانه پایش و مدیریت رخداد را از نزدیک ببینید
در جلسهٔ دمو، سامانه را روی یک سناریوی نزدیک به ساختار سازمان شما نشان میدهیم: نصب Agent، کشف سرویسها، باز شدن رخداد، Escalation و گزارش SLA. جلسه میتواند حضوری یا آنلاین باشد.
راههای ارتباطی
تلفن
021-91006070ایمیل
info@ipchavosh.comساعات کاری
شنبه تا پنجشنبه ۹-۱۸
هماهنگی جلسه
معمولاً ظرف یک روز کاری با شما تماس میگیریم
فرم درخواست دمو و جلسه
سامانه پایش و مدیریت رخداد را روی سناریوی سازمان خودتان ببینید. فرم را پر کنید تا برای تعیین وقت با شما تماس بگیریم.